AI & Poem에 시조 기능을 붙이고 가장 먼저 부딪힌 벽이 음절이었습니다. 초기에는 "봄을 소재로 시조 한 수 써 줘"라고 치면 분위기는 그럴듯한 석 줄이 나왔습니다. 그런데 음보마다 글자를 세 보면 율격이 어긋나 있었습니다. 종장 첫머리가 네 글자로 늘어지거나, 둘째 음보가 두 글자로 짧게 끝나 버렸습니다. 시조의 골격이 무너진 셈입니다.
모델의 토큰 경계와 한글 음절 경계는 다를 수 있습니다. "이 음보가 몇 음절인지"를 모델에게 물어도 답이 틀릴 수 있습니다. 그래서 프롬프트뿐 아니라 검산 방식도 바꿨습니다. 현재 AI & Poem은 언어를 한국어로, 형식을 '시조'로 선택하면 서버가 열두 음보를 직접 세고, 설정한 기준을 통과한 시만 보여 줍니다. 이 글에서는 전통 시조의 율격, 서비스의 검사 기준, 범용 챗봇용 프롬프트를 구분해 설명합니다.
평시조의 율격부터 정확히
기본형은 평시조입니다. 초장·중장·종장 세 장으로 이루어지고, 각 장은 네 음보씩, 모두 열두 음보입니다. 글자 수는 45자 안팎입니다. 음보마다 세 글자나 네 글자가 기본이고, 한두 글자는 더하거나 빼도 됩니다. 음수율의 기본형을 표로 정리하면 이렇습니다.
| 장 | 음보 1 | 음보 2 | 음보 3 | 음보 4 |
|---|---|---|---|---|
| 초장 | 3 | 4 | 3(4) | 4 |
| 중장 | 3 | 4 | 3(4) | 4 |
| 종장 | 3 (고정) | 5 이상 | 4 | 3 |
표의 3(4)는 해당 음보가 3음절 또는 4음절이라는 뜻입니다. 전통 시조의 음절 증감은 한국민족문화대백과사전 「시조」의 설명을 따릅니다. 서비스는 생성 기준을 더 좁게 잡아 초장·중장 3·4·3(4)·4, 종장 3·5·4·3만 허용합니다. 종장 둘째 음보는 정확히 5음절이며, 다른 자리의 증감은 허용하지 않습니다. 전통 시조의 모든 변형을 판정하는 규칙은 아닙니다.
종장이 시조를 시조로 만든다
시조와 다른 정형시를 가르는 지점이 종장에 있습니다. 두 규칙은 가감 없이 지켜야 합니다.
종장 첫 음보는 세 음절로 고정입니다. 두 음절도 네 음절도 안 됩니다. 이어지는 둘째 음보는 다섯 음절 이상으로, 다른 음보보다 길게 늘여서 마지막 호흡을 만듭니다. 이 한 번의 길이 변화가 시조에 매듭을 짓습니다. AI가 가장 자주 어기는 자리이자, 사람이 가장 먼저 검사할 곳입니다.
AI & Poem이 형식을 확인하는 방식
한국어 시조는 gpt-5-mini로 생성합니다. 형식 규칙은 시스템 메시지에, 주제는 별도 사용자 메시지에 담습니다. 모델에서 장별 네 음보를 JSON으로 받고, 서버가 NFC로 정규화한 뒤 완성형 한글 한 글자를 한 음절로 셉니다. 공백·탭과 허용한 문장부호는 세지 않으며, 숫자·외국 문자·미완성 자모·음보 안의 줄바꿈이 있으면 후보를 반려합니다.
검사에 실패하면 오류 위치와 실제 음절 수를 모델에 전달해 전체 시를 보정합니다. 최초 생성 1회와 보정 최대 2회, 전체 처리 예산은 25초입니다. 기준을 끝내 맞추지 못하면 HTTP 502, 시간이 초과되면 HTTP 504와 한국어 오류 안내를 반환합니다. 모델의 거절·콘텐츠 필터 응답은 보정 재시도 대상이 아닙니다. 통과한 시만 세 행으로 연결해 보여 주며, 생성은 10초를 넘길 수 있습니다.
율격을 AI에게 전달하는 프롬프트
아래는 ChatGPT·Claude 같은 범용 챗봇에서 쓰는 프롬프트 예시입니다. AI & Poem에서는 형식과 주제만 고르면 서버가 검산하므로 이 지시를 입력할 필요가 없습니다. 예시의 '5음절 이상'은 전통 시조 설명입니다. 서비스와 같은 기본형을 원하면 종장 둘째 음보를 정확히 5음절로 제한한다고 덧붙이세요. 모델의 자체 검산만으로 형식 준수가 보장되지는 않습니다.
먼저 음절 수를 숫자로 지정합니다.
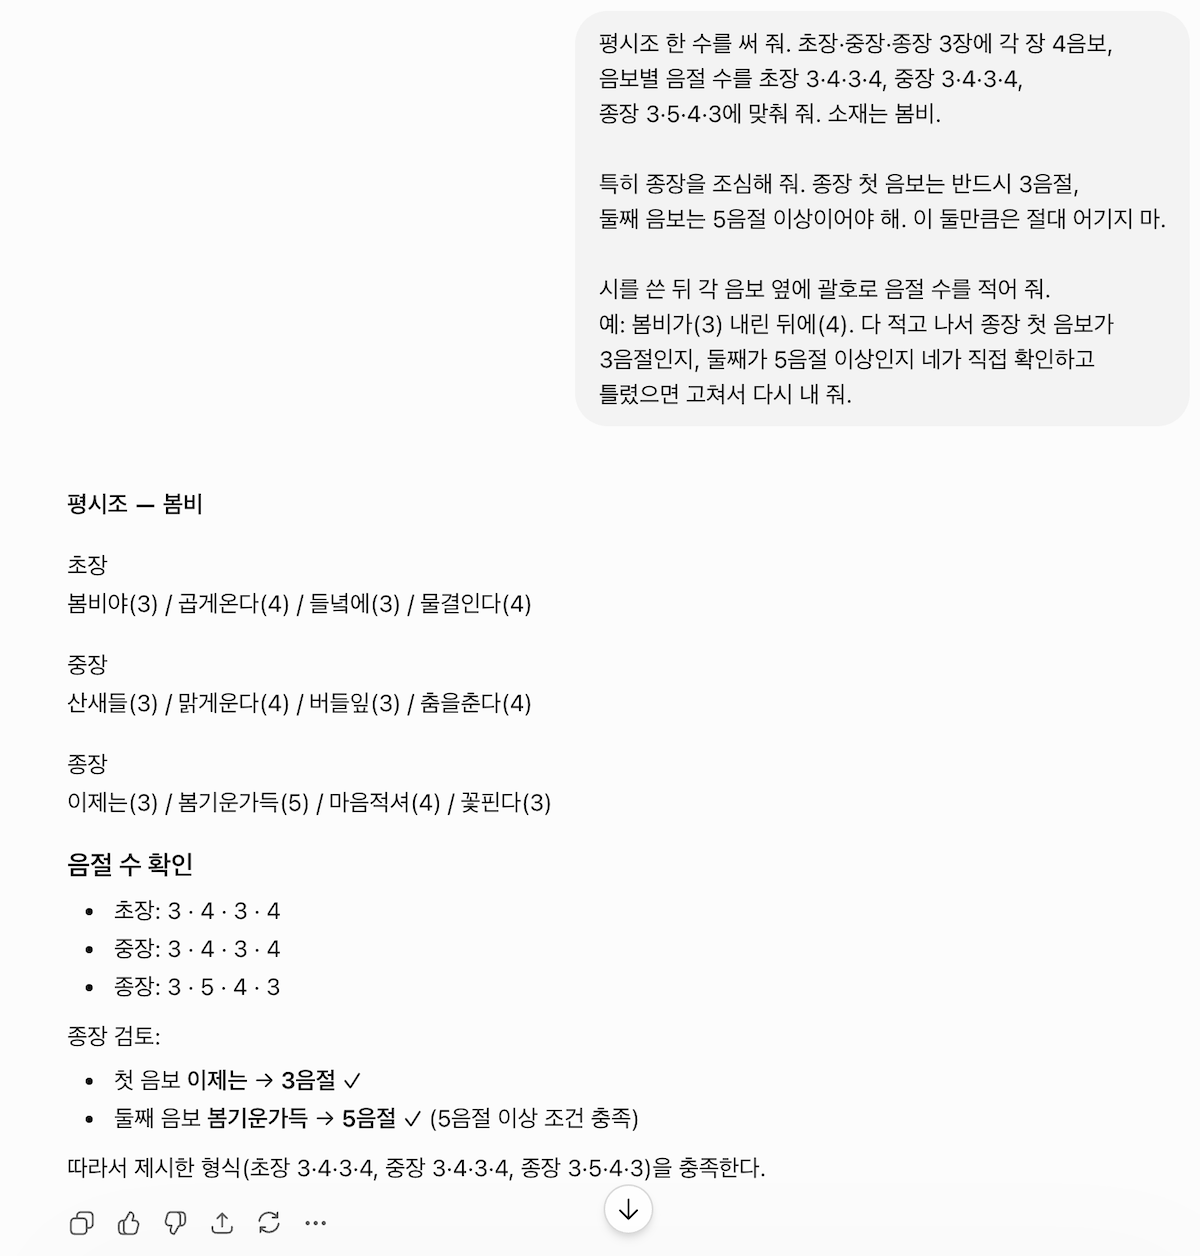
평시조 한 수를 써 줘. 초장·중장·종장 3장에 각 장 4음보,
음보별 음절 수를 초장 3·4·3·4, 중장 3·4·3·4,
종장 3·5·4·3에 맞춰 줘. 소재는 봄비.
그다음 종장 규칙만 따로 한 번 더 못 박습니다.
특히 종장을 조심해 줘. 종장 첫 음보는 반드시 3음절,
둘째 음보는 5음절 이상이어야 해. 이 둘만큼은 절대 어기지 마.
다 쓰고 나서 스스로 세어 검증하도록 시킵니다. 다만 모델이 적은 음절 수도 다시 확인해야 합니다.
시를 쓴 뒤 각 음보 옆에 괄호로 음절 수를 적어 줘.
예: 봄비가(3) 내린 뒤에(4). 다 적고 나서 종장 첫 음보가
3음절인지, 둘째가 5음절 이상인지 네가 직접 확인하고
틀렸으면 고쳐서 다시 내 줘.
음절을 잘못 세는 일이 잦으면 세는 방식까지 지정합니다.
음절은 한글 글자 수로 세어 줘. 받침은 따로 세지 마.
'꽃잎'은 2음절(꽃·잎)이야. 헷갈리면 [봄][비][가]처럼
글자를 하나씩 끊어 나열한 뒤 개수를 세 줘.
율격을 지킨 예와 어긴 예
아래 둘은 같은 소재(봄비)를 챗봇에 넣고 받은 결과입니다. 위 검증 프롬프트를 함께 준 쪽과, 그냥 '봄비로 시조 써 줘'만 준 쪽의 차이입니다. 각 음보 뒤 괄호 숫자가 음절 수입니다. 두 예는 율격 비교용이며, 서비스의 현재 성공률을 측정한 표본은 아닙니다.
봄비가(3) 내린 뒤에(4) 마당이(3) 젖어 든다(4)
처마 밑(3) 물방울이(4) 하늘을(3) 매달았다(4)
가만히(3) 손 모아 본다(5) 봄이 닿는(4) 손끝에(3)
종장 첫 음보 "가만히"가 3음절, 둘째 음보 "손 모아 본다"가 5음절입니다. 두 규칙을 모두 지켰습니다.
봄비가(3) 조용히(3) 내리는(3) 정원 안에서(5)
꽃들이(3) 비를 맞아(4) 더욱더(3) 싱그럽게 피어나(7)
아름다운(4) 봄(1) 풍경이(3) 그곳에 펼쳐지네(7)
종장 첫 음보 "아름다운"이 4음절이라 3음절 고정 규칙을 어겼고, 둘째 음보 "봄"이 1음절이라 5음절 이상 규칙도 어겼습니다. 초장·중장도 끝 음보가 5~7음절로 늘어져 호흡이 풀렸습니다. 분위기는 비슷해도 시조의 골격이 무너졌습니다.
기준이 되는 한 수
율격이 헷갈릴 때는 잘 알려진 옛 시조를 기준으로 삼으면 됩니다. 황진이의 시조가 종장 구조를 또렷이 보여 줍니다.
청산리 벽계수야 수이 감을 자랑 마라
일도창해하면 다시 오기 어려워라
명월이 만공산하니 쉬어 간들 어떠리
종장 "명월이"가 세 음절로 시작해 "만공산하니"로 길게 받습니다. 이 호흡을 머릿속에 두고 AI 출력과 맞대 보면, 어디가 어긋났는지 금세 잡힙니다.
음절 검사 뒤에 남는 일
현재 서비스가 보장하는 범위는 성공으로 반환한 시의 장 구성과 음보별 음절 수입니다. 모든 요청이 성공한다는 뜻은 아닙니다. 자연스러운 말마디, 문법, 주제에 맞는 이미지와 시상의 전환은 따로 읽고 판단해야 합니다. OpenAI 공식 문서도 구조화 출력에 내용 오류가 남을 수 있다고 설명합니다.
AI & Poem에서 시조를 받은 뒤 소리 내어 읽으며 표현을 다듬어 보세요. 직접 고친 문장은 서버가 다시 검사한 결과가 아니므로 음절 수도 재확인해야 합니다. 모델의 음절 세기가 어려운 이유와 서버 검증의 역할은 LLM과 한국어 시조 율격에서, 자유시를 다듬는 방법은 프롬프트 패턴 5가지에서 이어서 설명합니다.